
¿Por qué la objeción suena sensata y dónde está la trampa?
La preocupación es legítima en el fondo. Una automatización construida sobre datos sucios acelera de verdad el desorden: la regla de asignación de leads funciona a la perfección y reparte duplicados, el informe se genera al instante y cuenta a un cliente como tres. No es un riesgo hipotético, y justo por eso «primero los datos» es el instinto correcto.
El instinto se rompe con la escala. «Un CRM ordenado» es un estado que nunca se alcanza del todo, no una tarea con límites: mientras limpias el historial de tres años, los comerciales crean registros nuevos con las reglas de siempre. Un proyecto sin criterio de finalización no se termina; simplemente cansa. Tras un año de esa «etapa preparatoria», la empresa tiene la misma base, las mismas objeciones y un año menos de tiempo.
La salida no es desentenderse de la calidad de los datos. La salida es dejar de medir la preparación por el estado de toda la base y empezar a medirla por un escenario concreto.
¿Qué tres cosas distintas se llaman «no hay datos»?
Detrás de una misma frase se esconden tres diagnósticos distintos, y cada uno se trata de forma diferente:
- De verdad no hay datos: el evento no se registra en ninguna parte. No se pregunta el motivo del rechazo, no se anota el origen del contacto, las consultas repetidas no se vinculan con la primera. El vacío no está en la base: está en el proceso.
- Hay datos, pero están sucios: duplicados, distintas grafías de la misma empresa, campos obligatorios vacíos, «otro» en uno de cada dos registros. La información está, pero no se puede confiar en ella.
- Hay datos y están limpios, pero guardados en una estructura inservible. No se ha perdido nada; solo se ha registrado de tal manera que únicamente puede leerlo una persona que recuerda el contexto.
El tercer caso es el más frecuente y el que peor se reconoce: suele presentarse como si fuera el primero. «No tenemos datos para este informe» casi siempre significa que los datos están, solo que en una forma de la que no se pueden sacar. El primer caso exige empezar a recopilar, el segundo limpiar, el tercero reescribir la estructura, y solo el segundo tiene algo que ver con el tamaño de la base.
¿Cuál es el diagnóstico más frecuente?
Auspex tiene un ejemplo ilustrativo propio, en su CRM. En junio de 2026 la empresa reorganizó el embudo de leads de su portal de Bitrix24: 31 450 leads, 23 etapas.
El embudo se volvió inservible no por la cantidad de registros ni por lo sucios que estaban. En un solo eje, «etapa del lead», se habían mezclado tres dimensiones independientes: la etapa del proceso, el tipo de lead y el motivo de cierre. Por eso las etapas eran 23: se multiplicaban entre sí. Y los leads realmente activos eran unos 330, es decir, el uno por ciento.
No faltaba ni un bit de información. Se sabía en qué etapa estaba el lead, qué tipo de lead era y por qué se había cerrado. Lo imposible era obtener esas tres respuestas por separado, porque vivían en un mismo campo.
La corrección no consistió en reunir más datos, sino en desacoplar los ejes: la etapa responde solo por el proceso, y el tipo de lead y el motivo de cierre pasaron a campos separados. Las etapas quedaron en 9 en lugar de 23. En la migración se movieron 18 799 leads sin errores y más tarde se eliminaron 453 duplicados. El resto de los registros —el archivo de años anteriores y los duplicados— quedó en la estructura antigua y no pasó al nuevo embudo.
Tras una reestructuración así aparece algo que antes no existía: la posibilidad de hacerle una pregunta a la base. «Cuántos leads perdimos por precio en el trimestre» no tenía respuesta antes de la reorganización, y no porque faltaran los datos, sino porque el motivo de cierre no existía como una magnitud aparte.
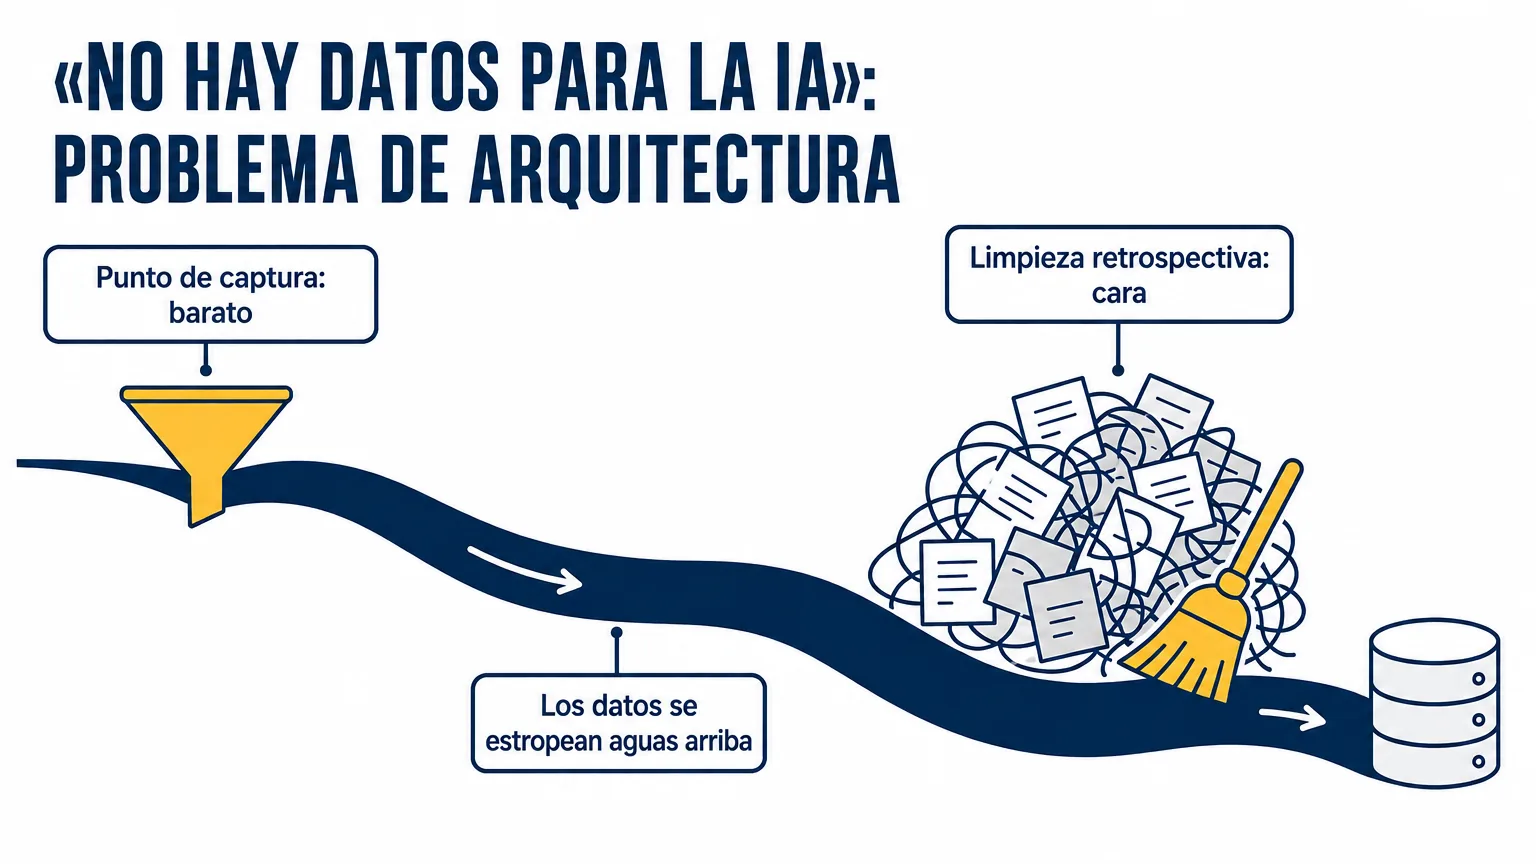
¿Por qué los datos se estropean aguas arriba?
La descripción más estudiada de este mecanismo es el trabajo de Sambasivan y coautores «Everyone wants to do the model work, not the data work», presentado en la conferencia CHI 2021 (Google Research). Los autores entrevistaron a 53 profesionales de IA en la India, países de África Oriental y Occidental y Estados Unidos, y describieron un fenómeno al que llamaron data cascades: eventos que se van acumulando y que provocan efectos negativos aguas abajo por problemas con los datos. Según sus datos, la prevalencia de estas cascadas es del 92%, y las describen con cuatro rasgos: pervasive, invisible, delayed, but often avoidable.
El estudio se refiere a sectores de alto riesgo —medicina, conservación de la naturaleza, crédito—, y sería incorrecto trasladar sus conclusiones al CRM de una empresa pequeña como si estuvieran demostradas. Pero el mecanismo, tal como lo formulan los autores, no depende del sector: el problema surge aguas arriba, se manifiesta con retraso y lejos del lugar donde se originó, y se detecta cuando ya se ha construido algo que se apoya en él.
La conclusión práctica está en la última palabra: avoidable. Las cascadas no son el precio inevitable de trabajar con datos; son consecuencia de no haberle prestado atención a la etapa de recopilación. Es un argumento no a favor de una limpieza general, sino a favor de reparar el lugar donde nacen los datos.
¿Cuántos datos necesita de verdad el primer escenario?
La comprobación lleva media hora y no requiere ni auditoría ni contratista. Toma el escenario que quieres lanzar primero y anota los campos que lee y en los que escribe.
- Respuesta inmediata a un lead entrante: canal de contacto, contacto, hora de creación, responsable. Cuatro campos.
- Recordatorio automático de reunión: fecha y hora, contacto, estado de confirmación. Tres campos.
- Control de oportunidades estancadas: etapa, fecha del último cambio de etapa, importe, responsable. Cuatro campos.
- Informe de motivos de pérdida: el motivo de cierre como campo aparte con una lista cerrada de valores. Un campo, que suele ser justo el que falta.
Esa lista es tu volumen de trabajo con los datos. Son de tres a cinco campos puestos en orden dentro del subconjunto que toca el escenario, no toda una base de diez mil registros. El resto de la base puede seguir sucio por ahora, y eso es orden de prioridades, no descuido: le llegará el turno cuando aparezca un escenario que lo necesite.
El efecto secundario de este ejercicio es más útil que la propia automatización. A menudo resulta que, de los cuatro campos necesarios, tres se rellenan bien y el cuarto no se rellena nunca, porque se creó hace dos años y a nadie se le explicó para qué. Eso ya es un problema de proceso, no de datos, y cuesta una conversación.
¿Por qué el punto de captura es más barato que la limpieza retrospectiva?
Recuperar datos de forma retrospectiva a veces no es solo caro, sino imposible, y ese es el argumento más fuerte a favor de reparar el punto de captura.
Esa misma migración de Auspex necesitó una precaución que a primera vista pasa inadvertida. En Bitrix24, el campo MOVED_TIME guarda la fecha del último cambio de etapa, y mover los leads en bloque lo habría sobrescrito con la fecha de la migración; es decir, el historial de «cuándo se estancó realmente el lead» habría desaparecido para siempre, en los 18 799 registros a la vez. No habría habido con qué arreglarlo después de la operación: el valor no está dañado, dejó de existir. Por eso la fecha original se guardó de antemano, en un campo aparte, antes de mover nada.
La limpieza solo trabaja con lo que se conservó. El punto de captura determina si se conserva algo en absoluto. Los cambios en él suelen ser pequeños y aburridos:
- motivo de cierre obligatorio con una lista cerrada de valores en lugar de texto libre;
- deduplicación por teléfono y correo en el momento de crear el registro, no en el momento del informe;
- normalización del formato de los números y de los nombres de empresa desde la entrada;
- un campo aparte para la forma jurídica, para que «Romashka S.L.» y «Romashka» no cuenten como dos clientes;
- autocompletado de lo que el sistema ya sabe por el historial de comunicación.
Ninguno de estos puntos parece un proyecto de IA. Son los que determinan si dentro de seis meses habrá sobre qué construirlo.
¿Cómo es el primer mes, mientras los datos siguen sucios?
El escenario se lanza sobre su subconjunto y funciona mientras el resto de la base sigue en el mismo estado de antes. En paralelo aparece algo que no existía antes del lanzamiento: retroalimentación sobre la calidad de los datos en un punto concreto. El campo de motivo de cierre, ya corregido, muestra en pocas semanas que la mitad de los valores de la lista de referencia no se usa nunca y que el que necesitan los comerciales no está en ella.
Conviene medir de forma acotada, dentro de ese mismo subconjunto:
- la proporción de registros del subconjunto del escenario con todos los campos completos;
- la cantidad de duplicados en ese mismo subconjunto, no en toda la base;
- el tiempo de preparación de un informe que antes se elaboraba a mano;
- la proporción de valores «otro» en las listas de referencia que lee el escenario.
Aun así, no hay en qué basar la promesa de un multiplicador concreto del efecto: depende del estado de la base y del flujo de operaciones, que antes de la auditoría se desconocen. Las cifras que aparecen en las propuestas comerciales y en los cálculos de retorno son un pronóstico a partir de los datos de partida de una empresa concreta, no un resultado medido.
¿Cuándo es válida la objeción?
Hay casos en los que «primero los datos» es la respuesta correcta, y nombrarlos con honestidad importa más que vender un piloto:
- El escenario lee toda la base y no un subconjunto: un envío masivo, la reactivación de contactos dormidos, los informes sobre todo el historial. Aquí la calidad de cada registro influye en el resultado, y los duplicados significan que el cliente recibirá dos correos.
- La decisión se toma de forma automática y es irreversible: un cobro, un pago, un cambio en las condiciones del contrato. El coste de un registro erróneo no se mide en incomodidad.
- El error es visible para el cliente. Un duplicado en la base es una segunda llamada a la misma persona el mismo día.
En estos casos funciona la secuencia descrita en el artículo «El negocio que se actualiza solo»: listas de referencia normalizadas, luego control en la entrada, luego cambios propuestos por la IA con confirmación humana. Ahí el orden importa más que la velocidad, y no conviene saltarse pasos.
La diferencia entre aquel artículo y este está en la pregunta que responde cada uno. Aquel trata del orden en que madura la capa de datos. Este, de cuánto trabajo hace falta para dar el primer paso. Ambos se reducen a lo mismo: el trabajo con los datos es inevitable, pero sus límites los fija el escenario, no el tamaño de la base.
¿Cuál es el siguiente paso?
Auspex es una empresa de implantación de CRM y automatización de procesos de negocio para pymes. La conversación sobre automatización empieza con dos preguntas, no con la elección de la herramienta ni con el tamaño de tu base: qué escenario quieres lanzar primero y qué cinco campos lee. La respuesta suele mostrar que hay más datos para empezar de lo que parecía, y menos trabajo. Una capa adicional de agentes de IA para soporte o cualificación de leads tiene sentido cuando esta capa está resuelta; de esa línea se ocupa Grow2.ai, nuestra división de IA.