
¿Qué es un negocio que se actualiza solo?
Clark describió el fenómeno así, al comentar una publicación de ingeniería del minorista chino JD: las herramientas modernas de IA permiten crear empresas en las que la inteligencia está entretejida en las funciones de back office (por ejemplo, en la gestión de inventario). Esas empresas operan a escalas mucho mayores de lo que antes era posible y, además, son capaces de actualizarse y seguir aprendiendo por sí mismas, a menudo sin grandes cantidades de supervisión humana.
Las herramientas modernas de IA nos permiten crear negocios que tienen la inteligencia entretejida en sus funciones de back office, como la gestión de inventario.
— Jack Clark, Import AI #464
La palabra clave aquí es «entretejida». No «puesta encima», no «conectada por un costado». Lo que la mayoría de las empresas llama automatización vive en una capa aparte: un robot recoge las solicitudes una vez por hora, un bot responde una pregunta típica. Quita esa capa y el negocio sigue funcionando, solo que más lento. Un sistema que se actualiza solo está hecho al revés: es parte de cómo la empresa llega siquiera a saber lo que ocurre en ella.
Cómo se ve en JD: ¿por qué la ontología vive fuera del modelo?
A JD suelen llamarla el Amazon de China. Según las cifras que cita Import AI, la empresa tiene 700 millones de usuarios, millones de vendedores y un catálogo de decenas de miles de millones de SKU. Gestionar a mano un catálogo así es imposible por principio: es una cuestión de aritmética, no de esmero.
JD describió el sistema que se encarga de esto en una publicación de investigación: Oxygen AI Item Center. Según la empresa, abarca decenas de miles de categorías y procesa cientos de millones de actualizaciones de fichas de producto al día. Para un negocio de 20 personas esas cifras no vienen al caso. Lo que conviene trasladar no es la escala, sino la decisión de arquitectura que hay detrás.
La ontología —es decir, la estructura de conocimiento sobre qué es un producto, a qué categoría pertenece y qué atributos tiene— JD la sacó del modelo y la llevó a una base de conocimiento aparte. Gracias a eso, la ontología se puede actualizar de forma continua sin reentrenar el modelo. Al modelo le dejaron un papel acotado: primero el sistema busca en la base las entradas pertinentes, y el modelo solo determina si el producto coincide con la entrada encontrada. La publicación dice expresamente para qué se hizo así: reduce de forma sustancial la complejidad de la tarea y baja el riesgo de alucinaciones.
¿Por qué no se trata de «un agente que lo hará todo por ti»?
En el mismo número de Import AI hay cifras que conviene tener a mano cuando te venden un agente autónomo de extremo a extremo. En el benchmark OSWorld 2.0, donde los sistemas de IA ejecutan tareas reales y largas en un ordenador, la configuración más potente en el momento de la medición (junio de 2026) logró un 20,6% de ejecuciones totalmente correctas y un 54,8% de parciales. En la clasificación del benchmark a octubre de 2026, Claude Opus 5 llega ya al 44,33% en la versión actualizada del conjunto de tareas, todavía menos de la mitad. Los autores señalan que el resultado cae bruscamente a medida que la tarea se alarga, y que lo que más les cuesta a los agentes es justo aquello de lo que está hecho el trabajo operativo: recuperar un estado oculto, no perder de vista muchos objetos, resolver datos contradictorios y adaptarse a requisitos que han cambiado.
La segunda dimensión del mismo panorama es Remote Labor Index, un benchmark conjunto del Center for AI Safety y Scale Labs (Scale AI). Aquí los modelos realizan proyectos freelance reales y remunerados, completos de principio a fin, y el trabajo lo acepta un cliente humano, no una prueba automática. En el lanzamiento, en octubre de 2025, el mejor resultado fue un 2,5% de proyectos aceptados; en julio de 2026, un 15,8%. En menos de un año el resultado se ha multiplicado por más de seis, y la dirección es inequívoca. Pero incluso a octubre de 2026 el mejor resultado ronda el 21%.
La apuesta por un agente que lleva por su cuenta un proceso de extremo a extremo se apoya, a octubre de 2026, exactamente en estas dos mediciones: alrededor de un 21% de proyectos aceptados en Remote Labor Index y un 44,33% de ejecuciones totalmente correctas en la versión actualizada de OSWorld 2.0, ambas por debajo de la mitad. La apuesta por una capa de datos que se actualiza sola es una apuesta por una tarea que JD redujo, y no por casualidad, a «coincide o no»: acotada, repetible y barata de verificar. La automatización arraiga donde verificar el resultado cuesta céntimos.
¿Qué limita de verdad el crecimiento sin contratar?
Cuando una pyme toca techo, la causa se formula como falta de manos. Al mirar de cerca los procesos concretos, casi siempre se ve otra cosa: no faltan manos para ejecutar, falta una descripción actualizada del negocio. Buena parte de esa descripción no está escrita en ninguna parte: vive en la cabeza de los empleados.
- Listas de referencia de fuentes, estados y categorías en las que la mitad de los valores ha aparecido por casualidad y ya no significa nada.
- El mismo cliente en varias fichas, porque llegó por el sitio web, por Instagram y por recomendación.
- Un catálogo de productos en el que los nombres y las características los completa quien llegó primero y como los entendió.
- Excepciones de precio y acuerdos que recuerda un comercial concreto y nadie más.
- Motivos de pérdida de oportunidades elegidos al azar, porque el campo es obligatorio y las opciones no describen la realidad.
El volumen crece, y con él crece la cantidad de excepciones no escritas que alguien tiene que guardar en la memoria. Contratar se vuelve obligatorio no porque más clientes exijan más manos, sino porque cada nuevo portador de conocimiento hace falta para que el sistema siga siendo comprensible. Contratas personas para que hagan de documentación viva.
Un back office que se actualiza solo rompe justamente ese vínculo. Si las listas de referencia se normalizan solas y los duplicados no llegan al informe, la descripción del negocio deja de depender de quién está hoy en su puesto. Entonces el volumen crece más rápido que la plantilla, porque ha desaparecido el trabajo que antes obligaba a contratar.
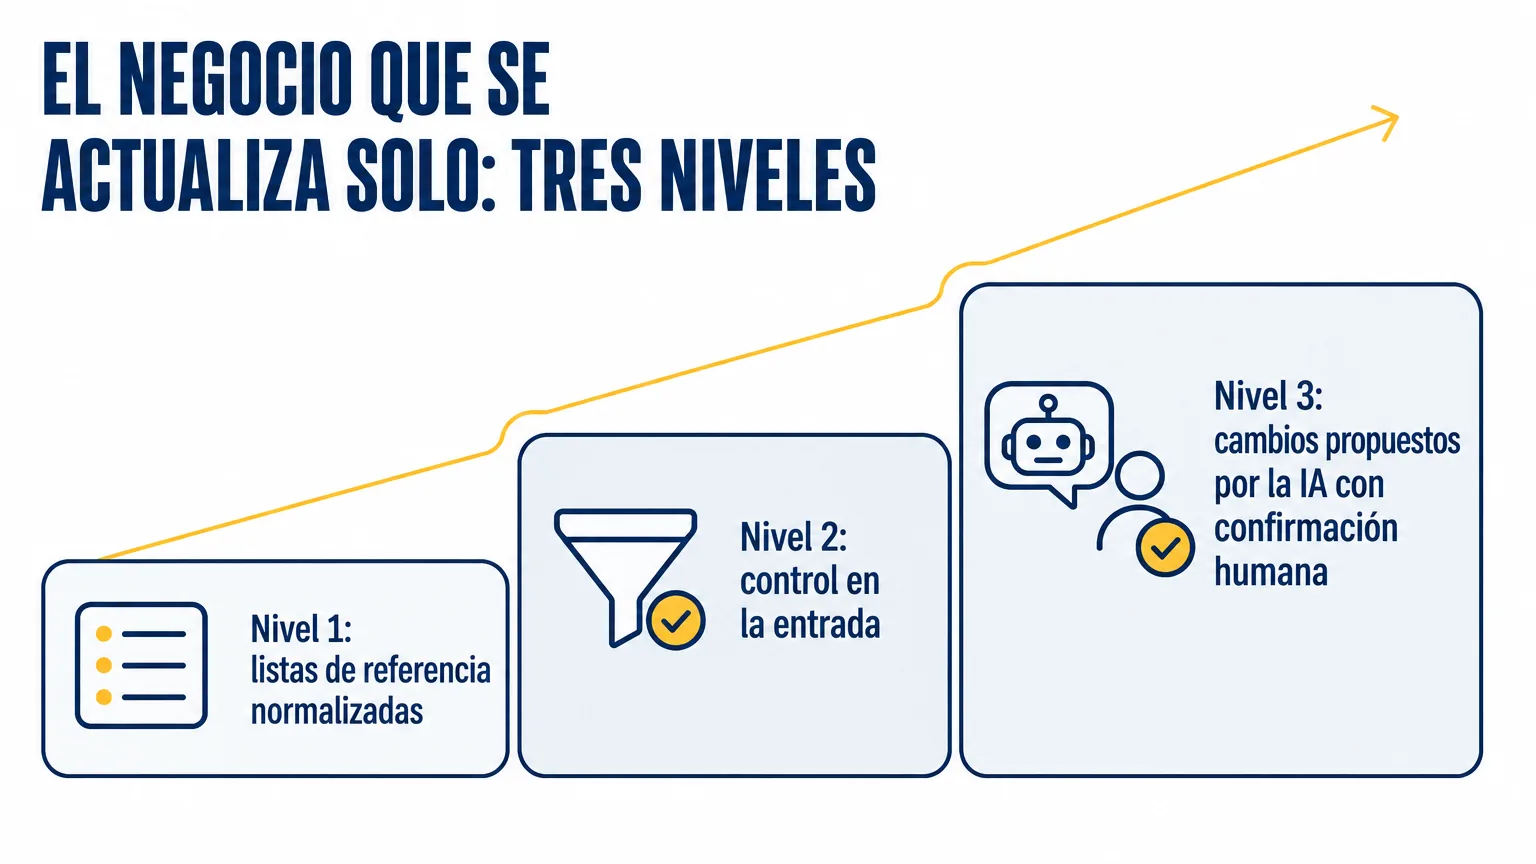
Nivel 1: listas de referencia normalizadas
El nivel más aburrido y el más rentable. Valores únicos y acordados para fuentes de leads, estados de clientes y de oportunidades, productos, regiones, motivos de pérdida y tipos de solicitud. Como paso aparte conviene separar la forma jurídica del nombre de la marca: sin eso, «TOV Romashka», «Romashka» y «Romashka LLC» cuentan como tres clientes distintos, y cualquier informe de ventas repetidas miente. Aquí todavía no hay nada de IA, pero sin este nivel lo demás no funciona.
Nivel 2: control en la entrada
La base se echa a perder en el momento en que se crea el registro, no poco a poco. Por eso la verificación se traslada a la entrada: deduplicación por teléfono y correo antes de que aparezca una segunda ficha, normalización inmediata del formato de números y nombres, autocompletado de los campos obligatorios a partir del historial de comunicación. Es la misma idea que en JD, solo que a escala de pyme: el sistema coteja el objeto nuevo con la lista de referencia existente y resuelve una pregunta acotada sobre la coincidencia.
Nivel 3: cambios propuestos por la IA con confirmación humana
El nivel más alto al alcance de una pyme hoy sin un riesgo excesivo. La IA escanea la base con regularidad y propone cambios: fusionar estas fichas, añadir un valor a la lista de referencia porque 40 oportunidades en un trimestre han usado «otro», marcar un contacto como no válido. La decisión sigue siendo de una persona, pero esa persona trabaja con una lista de propuestas, no con una base de diez mil registros. Es aquí donde aparece la propiedad de actualizarse solo, y es aquí donde resulta segura, porque cada propuesta se revisa en segundos.
Por dónde empezar: ¿qué secuencia aplica Auspex?
- Auditoría de datos: qué proporción hay de duplicados, campos obligatorios vacíos, contactos inactivos y nombres inconsistentes.
- Reglas de datos: campos obligatorios, formatos de teléfono y correo, grafías canónicas de las empresas, lista cerrada de estados.
- Limpieza y deduplicación: fusionar los duplicados existentes, archivar lo que ya no está vigente, completar las fichas con el historial.
- Orden en las listas de referencia: valores únicos para fuentes, categorías, regiones, productos y motivos de pérdida.
- Automatización de la rutina: asignación de leads, recordatorios, seguimiento, informes, control de oportunidades estancadas.
- Control periódico: revisión semanal de los registros nuevos y escaneo completo de la base cada mes.
Aquí el orden importa más que la velocidad. Los puntos 1–4 no tienen una demo vistosa, y son justo los que más a menudo te proponen saltarte para «llegar más rápido a la IA». Si se omiten, convierten cualquier automatización posterior en un acelerador del desorden: la regla de asignación de leads funciona de forma impecable y reparte duplicados, el informe se genera al instante y cuenta a un cliente como tres.
Test: ¿tu back office ya se actualiza solo?
- ¿Cuánto tiempo llevará preparar el informe de ventas repetidas del trimestre, y le creerá el director financiero sin una revisión manual?
- ¿Qué pasará con la calidad de los datos si el comercial con más experiencia se va tres semanas de vacaciones?
- ¿Cuántos días necesita un empleado nuevo para entender qué estado poner en una situación que no es obvia?
- ¿Quién notará que ha aparecido un duplicado de un cliente: el sistema o un cliente molesto al que han llamado dos veces?
- ¿Cuándo fue la última vez que alguien revisó la lista de valores de los motivos de pérdida?
Si las respuestas a estas preguntas dependen de personas concretas y no de mecanismos concretos, el back office se sostiene en la memoria del equipo. Eso funciona hasta cierto volumen; después, cada punto porcentual adicional de crecimiento hay que comprarlo contratando.
¿Qué da esto en cifras y qué no prometemos?
Aquí no existe un multiplicador universal, y quien lo nombre antes de la auditoría se lo está inventando. El efecto depende de lo descuidada que esté la base al inicio y de cuántas operaciones pasen por ella cada día. Lo que sí se puede medir antes y después: la proporción de duplicados en la base, las horas dedicadas a preparar los informes periódicos, el tiempo que tarda un comercial nuevo en trabajar de forma autónoma, la proporción de oportunidades con todos los datos completos. Estas métricas se obtienen en una semana y no requieren fe.
Un ejemplo ilustrativo de efecto acumulado es GRO, una tienda y servicio técnico ucraniano de tecnología Apple (la empresa aceptó que se publicara). Auspex acompaña a la empresa como integrador de CRM desde 2021: implantación del sistema, automatización del área de ventas, sincronización del CRM con el ERP. En este tiempo GRO ha pasado de unos 10 pedidos al mes a 10 al día. Es el resultado de varios años de trabajo constante sobre procesos y datos, no la consecuencia de una sola implantación. El horizonte realista de cambios así se mide en años, no en trimestres.
¿Cuál es el siguiente paso?
Auspex es una empresa de implantación de CRM y automatización de procesos de negocio para pymes. No empezamos por elegir una herramienta, sino por preguntar qué datos exactamente pierde tu negocio cada día y cuántas horas de trabajo humano se van en mantener el sistema en un estado razonable. Cuando esa capa está resuelta, los agentes de IA que se montan encima, para soporte o cualificación de leads, realmente tienen sobre qué apoyarse; de esa línea se ocupa Grow2.ai, nuestra división de IA.