
Что такое самообновляющийся бизнес?
Кларк описал явление так, комментируя инженерную публикацию китайского ритейлера JD: современные AI-инструменты позволяют создавать компании, в которых интеллект вплетён в бэк-офисные функции — например, в управление товарными запасами. Такие компании работают в гораздо больших масштабах, чем было возможно раньше, и при этом способны сами обновляться и доучиваться, зачастую без плотного человеческого надзора.
Современные AI-инструменты позволяют нам создавать бизнесы, в которых интеллект вплетён в бэк-офисные функции, например в управление запасами.
— Jack Clark, Import AI #464
Ключевое слово здесь — «вплетён». Не «поставлен сверху», не «подключён сбоку». То, что большинство компаний называет автоматизацией, живёт отдельным слоем: робот раз в час забирает заявки, бот отвечает на типовой вопрос. Уберите этот слой — бизнес продолжит работать, просто медленнее. Самообновляющаяся система устроена наоборот: она часть того, как компания вообще знает, что у неё происходит.
Как это выглядит у JD: почему онтология живёт вне модели?
JD часто называют китайским аналогом Amazon. По цифрам, которые приводит Import AI, у компании 700 миллионов пользователей, миллионы продавцов и каталог на десятки миллиардов товарных позиций. Управлять таким каталогом вручную невозможно в принципе — это вопрос арифметики, а не старательности.
Систему, которая этим занимается, JD описала в исследовательской публикации: Oxygen AI Item Center. По словам компании, она охватывает десятки тысяч категорий и обрабатывает сотни миллионов обновлений товарных карточек в сутки. К бизнесу на 20 человек эти цифры отношения не имеют. Переносить стоит не масштаб, а архитектурное решение, которое за ним стоит.
Онтологию — то есть структуру знаний о том, что такое товар, к какой категории он относится и какие у него атрибуты, — JD вынесла из модели наружу, в отдельную базу знаний. Благодаря этому онтологию можно непрерывно обновлять без переобучения модели. Самой модели оставили узкую роль: сначала система ищет подходящие записи в базе, а модель лишь определяет, совпадает ли товар с найденной записью. В публикации прямо сказано, зачем так сделано: это существенно уменьшает сложность задачи и снижает риск галлюцинаций.
Почему речь не об «агенте, который сделает всё за вас»?
В том же выпуске Import AI есть цифры, которые полезно держать под рукой, когда вам продают сквозного автономного агента. На бенчмарке OSWorld 2.0, где AI-системы выполняют длинные реальные задачи за компьютером, самая сильная на момент замера (июнь 2026) конфигурация показала 20,6% полностью правильно выполненных задач и 54,8% частично выполненных. В таблице лидеров бенчмарка на октябрь 2026 года Claude Opus 5 на обновлённой версии набора задач даёт уже 44,33% — и всё ещё меньше половины. Авторы отмечают, что результат резко падает с ростом длины задачи, а труднее всего агентам даётся именно то, из чего состоит операционная работа: восстановить скрытое состояние, удерживать в поле зрения много объектов, разбираться с противоречивыми данными и подстраиваться под изменившиеся требования.
Второе измерение той же картины — Remote Labor Index, совместный бенчмарк Center for AI Safety и Scale Labs (Scale AI). Здесь модели выполняют настоящие оплачиваемые фриланс-проекты целиком, от начала до конца, а работу принимает живой заказчик, а не автотест. На старте, в октябре 2025-го, лучший результат составлял 2,5% принятых проектов, в июле 2026-го — 15,8%. Меньше чем за год рост более чем шестикратный, и направление однозначное. Но даже на октябрь 2026 года лучший результат — около 21%.
Ставка на агента, который самостоятельно ведёт сквозной процесс, на октябрь 2026 года опирается ровно на эти два замера: около 21% принятых проектов в Remote Labor Index и 44,33% полностью правильно выполненных задач на обновлённой версии OSWorld 2.0 — оба ниже половины. Ставка на самообновляющийся слой данных — это ставка на задачу, которую JD не случайно сузила до «совпадает или нет»: узкую, повторяемую и дешёвую в проверке. Автоматизация приживается там, где проверка результата стоит копейки.
Что на самом деле ограничивает рост без найма?
Когда SMB упирается в потолок, причину формулируют как нехватку рук. Но если присмотреться к конкретным процессам, почти всегда видишь другую картину: не хватает не рабочих рук, а актуального описания бизнеса. Значительная часть этого описания нигде не записана — она живёт в головах сотрудников.
- Справочники источников, статусов и категорий, в которых половина значений появилась случайно и уже ничего не означает.
- Один и тот же клиент в нескольких карточках, потому что пришёл с сайта, из Instagram и по рекомендации.
- Товарный каталог, где названия и характеристики заполняет тот, кто успел, и так, как понял.
- Ценовые исключения и договорённости, которые помнит конкретный менеджер и больше никто.
- Причины потери сделок, выбранные наугад, потому что поле обязательное, а варианты не описывают реальность.
Объём растёт — и вместе с ним растёт число неписаных исключений, которые кто-то должен держать в памяти. Наём становится обязательным не потому, что больше клиентов требует больше рук, а потому, что каждый новый носитель знаний нужен, чтобы система оставалась понятной. Вы нанимаете людей на роль живой документации.
Самообновляющийся бэк-офис разрывает именно эту связь. Если справочники нормализуются сами, а дубли не доживают до отчёта, описание бизнеса перестаёт зависеть от того, кто сегодня на месте. Объём тогда растёт быстрее штата, потому что исчезла работа, которая раньше требовала найма.
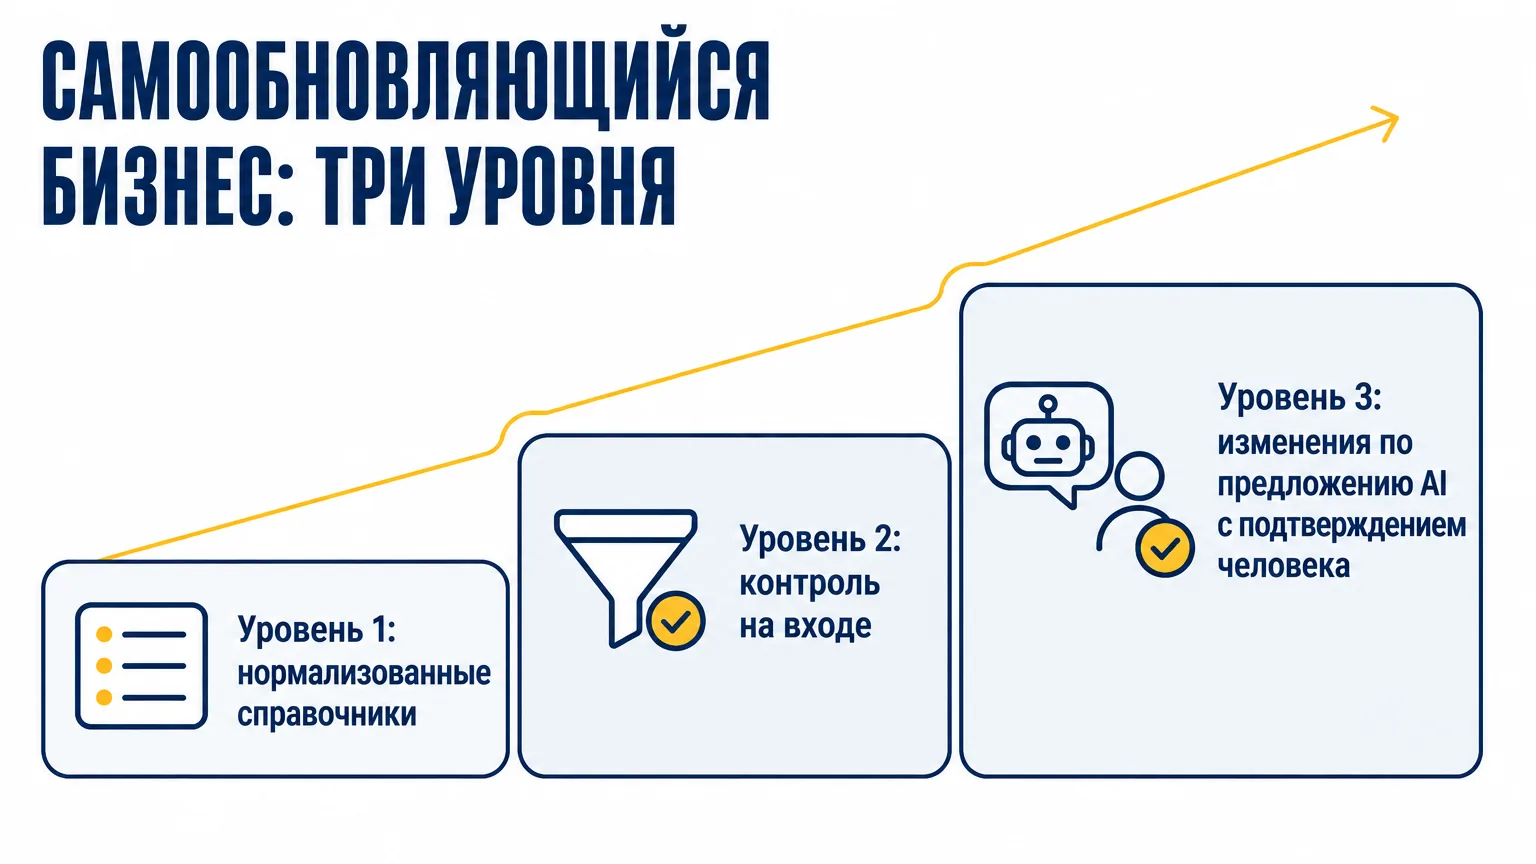
Уровень 1: нормализованные справочники
Самый скучный и самый прибыльный уровень. Единые согласованные значения для источников лидов, статусов клиентов и сделок, продуктов, регионов, причин потери, типов обращений. Отдельно стоит развести юридическую форму и название бренда: без этого «ООО Ромашка», «Ромашка» и «Romashka LLC» считаются тремя разными клиентами, и любой отчёт о повторных продажах врёт. Здесь ещё нет никакого AI — но без этого уровня остальное не работает.
Уровень 2: контроль на входе
База портится в момент создания записи, а не постепенно. Поэтому проверка переезжает на вход: дедупликация по телефону и почте до появления второй карточки, нормализация формата номеров и названий сразу, автозаполнение обязательных полей из истории коммуникации. Это та же идея, что и у JD, только в масштабе SMB: система сверяет новый объект с имеющимся справочником и решает узкий вопрос о совпадении.
Уровень 3: изменения по предложению AI с подтверждением человека
Самый высокий уровень, доступный SMB сегодня без чрезмерного риска. AI регулярно сканирует базу и предлагает изменения: объединить вот эти карточки, добавить значение в справочник, потому что в 40 сделках за квартал выбрали «другое», пометить контакт как недействительный. Решение остаётся за человеком, но человек работает со списком предложений, а не с базой на десять тысяч записей. Именно здесь появляется свойство самообновления — и именно здесь оно безопасно, потому что каждое предложение проверяют за секунды.
С чего начать: какую последовательность применяет Auspex?
- Аудит данных: какова доля дублей, пустых обязательных полей, неактивных контактов и несогласованных названий.
- Правила данных: обязательные поля, форматы телефонов и почты, канонические написания компаний, закрытый перечень статусов.
- Очистка и дедупликация: объединить имеющиеся дубли, заархивировать неактуальное, дополнить карточки из истории.
- Упорядочение справочников: единые значения для источников, категорий, регионов, продуктов, причин потери.
- Автоматизация рутины: распределение лидов, напоминания, follow-up, отчёты, контроль зависших сделок.
- Регулярный контроль: еженедельный просмотр новых записей и ежемесячный полный скан базы.
Порядок здесь важнее скорости. У пунктов 1–4 нет эффектного демо, и именно их чаще всего предлагают пропустить, чтобы «быстрее дойти до AI». Если их пропустить, любая дальнейшая автоматизация превращается в ускоритель беспорядка: правило распределения лидов работает безупречно и распределяет дубли, отчёт строится мгновенно и считает одного клиента за трёх.
Тест: ваш бэк-офис уже самообновляющийся?
- Сколько времени уйдёт на подготовку отчёта о повторных продажах за квартал — и поверит ли ему финансовый директор без ручной проверки?
- Что будет с качеством данных, если самый опытный менеджер уйдёт в отпуск на три недели?
- Сколько дней нужно новому сотруднику, чтобы понять, какой статус ставить в неочевидной ситуации?
- Кто заметит появление дубля клиента — система или раздражённый клиент, которому позвонили дважды?
- Когда в последний раз кто-то пересматривал перечень значений в справочнике причин потери?
Если ответы на эти вопросы упираются в конкретных людей, а не в конкретные механизмы, значит, бэк-офис держится на памяти команды. Это работает до определённого объёма, а дальше каждый следующий процент роста приходится покупать наймом.
Что это даёт в цифрах — и чего мы не обещаем?
Универсального множителя здесь не существует, и любой, кто называет его до аудита, выдумывает. Эффект зависит от того, насколько запущена база на старте и сколько операций проходит через неё ежедневно. Что действительно можно измерить до и после: долю дублей в базе, часы на подготовку регулярной отчётности, время выхода нового менеджера на самостоятельную работу, долю сделок с полностью заполненными данными. Эти метрики снимаются за неделю и не требуют веры.
Показательный пример накопленного эффекта — GRO, украинский магазин и сервисный центр техники Apple (компания согласилась на публикацию). Auspex сопровождает компанию как интегратор CRM с 2021 года: внедрение системы, автоматизация отдела продаж, синхронизация CRM с ERP. За это время GRO вырос примерно с 10 заказов в месяц до 10 в день. Это результат нескольких лет последовательной работы над процессами и данными, а не следствие одного внедрения. Реалистичный горизонт таких изменений измеряется годами, а не кварталами.
Какой следующий шаг?
Auspex — компания по внедрению CRM и автоматизации бизнес-процессов для SMB. Мы начинаем не с выбора инструмента, а с вопроса, какие именно данные ваш бизнес теряет каждый день и сколько человеческих часов уходит на то, чтобы удерживать систему во вменяемом состоянии. Когда этот слой закрыт, надстройке в виде AI-агентов для поддержки или квалификации лидов действительно есть на чём стоять — этим направлением занимается Grow2.ai, наше AI-подразделение.