
Почему возражение звучит разумно — и где в нём подмена?
Беспокойство справедливо по существу. Автоматизация, построенная на грязных данных, действительно множит беспорядок: правило распределения лидов работает безупречно и распределяет дубли, отчёт строится мгновенно и считает одного клиента за троих. Это не гипотетический риск, и именно поэтому «сначала данные» — правильный инстинкт.
Ломается инстинкт на масштабе. «Порядок в CRM» — состояние, которого не достигают окончательно, а не задача с границами: пока вы чистите историю за три года, менеджеры создают новые записи по старым правилам. Проект без критерия завершения не завершается, он просто надоедает. Через год такого «подготовительного этапа» у компании та же база, те же возражения и на год меньше времени.
Выход не в том, чтобы махнуть рукой на качество данных. Выход в том, чтобы перестать мерить готовность состоянием всей базы и начать мерить её конкретным сценарием.
Какие три разные вещи называют «нет данных»?
За одной фразой скрываются три разных диагноза, и лечатся они по-разному:
- Данных действительно нет: событие не фиксируется нигде. Причину отказа не спрашивают, источник обращения не записывают, повторные обращения не связывают с первым. Пусто не в базе — пусто в процессе.
- Данные есть, но грязные: дубли, разные написания одной и той же компании, пустые обязательные поля, «другое» в каждой второй записи. Информация присутствует, доверять ей нельзя.
- Данные есть, и они чистые, но лежат в непригодной структуре. Ничего не потеряно, только записано так, что прочитать это может лишь человек, который помнит контекст.
Третий случай самый частый и хуже всего распознаётся — о нём регулярно сообщают как о первом. «У нас нет данных для этого отчёта» почти всегда означает, что данные есть, просто лежат в форме, из которой их не достать. Первый случай требует начать собирать, второй — почистить, третий — переписать структуру, и только второй имеет хоть какое-то отношение к объёму базы.
Какой диагноз самый частый?
Показательный пример есть у самого Auspex, в собственной CRM. В июне 2026 года компания реорганизовала воронку лидов на своём портале Bitrix24: 31 450 лидов, 23 стадии.
Воронка стала непригодной не из-за количества записей и не из-за их загрязнённости. В одну ось «стадия лида» были свалены три независимых измерения: стадия процесса, тип лида и причина закрытия. Поэтому стадий оказалось 23 — они перемножались. Реально активными при этом были около 330 лидов, то есть один процент.
Информации хватало полностью, до последнего бита. Было известно, на каком этапе лид, что это за лид и почему его закрыли. Получить эти три ответа по отдельности было невозможно, потому что они жили в одном поле.
Исправление состояло не в том, чтобы собрать больше данных, а в том, чтобы расцепить оси: стадия отвечает только за процесс, тип лида и причина закрытия переехали в отдельные поля. Стадий стало 9 вместо 23. При миграции переместили 18 799 лидов без ошибок, позже удалили 453 дубля. Остальные записи — архив давних лет и дубли — остались в старой структуре и в новую воронку не переехали.
После такой перестройки появляется то, чего раньше не было, — возможность задать базе вопрос. У вопроса «сколько лидов мы потеряли из-за цены за квартал» до реорганизации не было ответа не потому, что данные отсутствовали, а потому, что причина закрытия не существовала как отдельная величина.
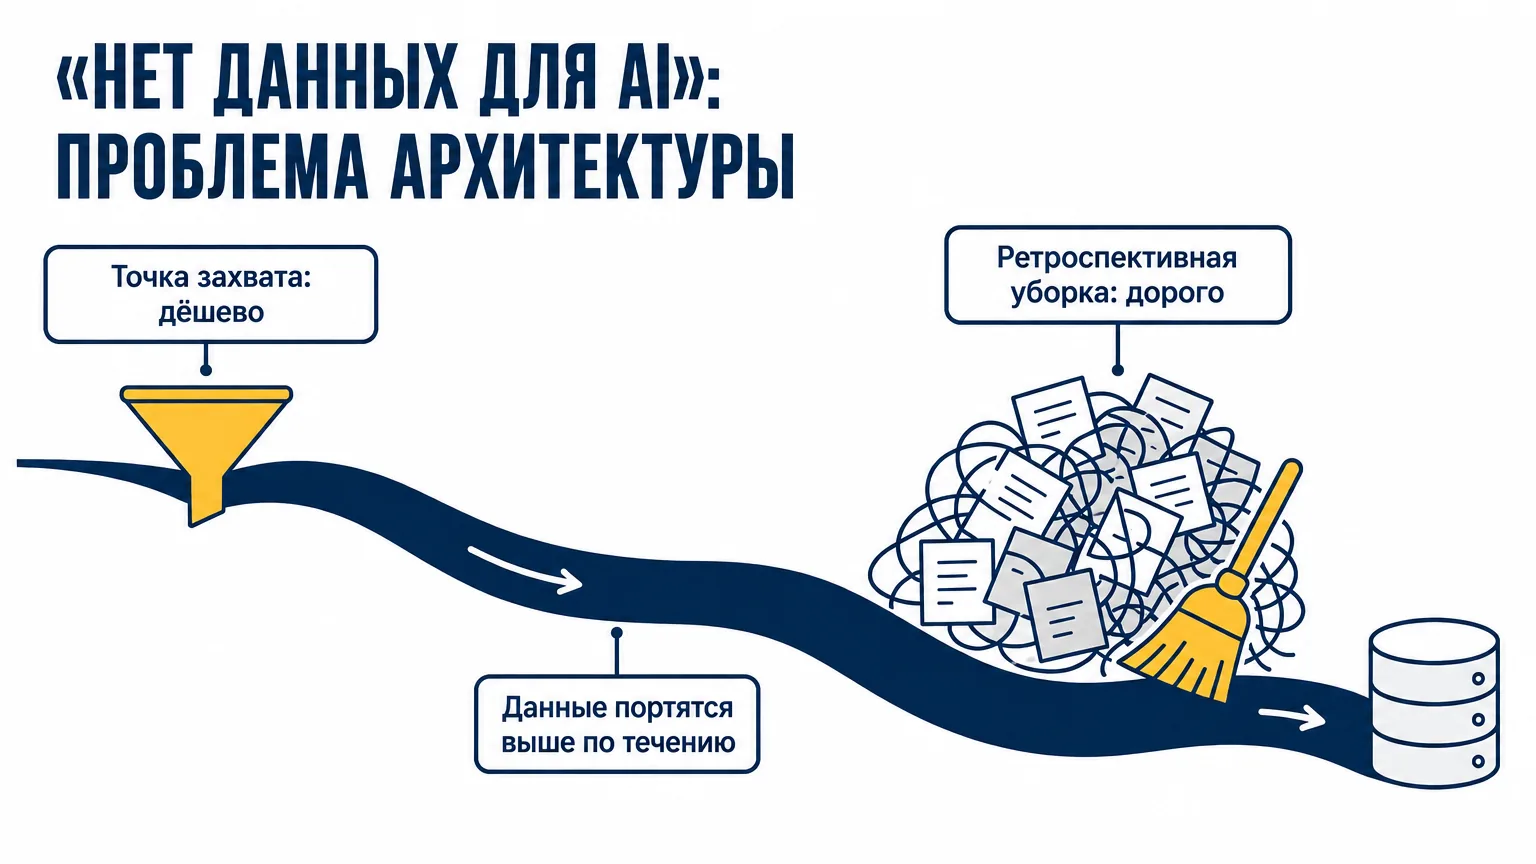
Почему данные портятся выше по течению?
Лучше всего этот механизм исследован в работе Sambasivan и соавторов «Everyone wants to do the model work, not the data work», представленной на конференции CHI 2021 (Google Research). Авторы провели интервью с 53 AI-практиками в Индии, странах Восточной и Западной Африки и США и описали явление, которое назвали data cascades: накапливающиеся события, которые из-за проблем с данными вызывают негативные последствия ниже по течению. По их данным, распространённость таких каскадов составляет 92%, а описывают они их четырьмя признаками — pervasive, invisible, delayed, but often avoidable.
Исследование касается высокорисковых областей — медицины, охраны природы, кредитования, — и переносить его выводы на CRM небольшой компании как доказанные было бы некорректно. Но сам механизм в формулировке авторов не зависит от отрасли: проблема возникает выше по течению, проявляется с задержкой и далеко от места возникновения, а замечают её тогда, когда уже построено что-то, что на неё опирается.
Практический вывод содержится в последнем слове: avoidable. Каскады — не неизбежная плата за работу с данными: они следствие того, что этапу сбора не уделили внимания. Это аргумент не в пользу генеральной уборки, а в пользу ремонта того места, где данные рождаются.
Сколько данных на самом деле нужно первому сценарию?
Проверка занимает полчаса и не требует ни аудита, ни подрядчика. Возьмите сценарий, который хотите запустить первым, и выпишите поля, которые он читает и в которые пишет.
- Мгновенный ответ на входящий лид: канал обращения, контакт, время создания, ответственный. Четыре поля.
- Автонапоминание о встрече: дата и время, контакт, статус подтверждения. Три поля.
- Контроль зависших сделок: стадия, дата последней смены стадии, сумма, ответственный. Четыре поля.
- Отчёт о причинах потери: причина закрытия как отдельное поле с закрытым списком значений. Одно поле, которого обычно и не хватает.
Этот список и есть ваш объём работы с данными. Это три-пять полей, приведённые в порядок в том срезе, которого касается сценарий, а не вся база на десять тысяч записей. Остальная база пока может оставаться грязной, и это очерёдность, а не небрежность: до неё дойдёт очередь тогда, когда появится сценарий, которому она нужна.
Побочный эффект такого упражнения полезнее самой автоматизации. Часто оказывается, что из четырёх нужных полей три заполняются исправно, а четвёртое не заполняется никогда, потому что его ввели два года назад и никому не объяснили зачем. Это уже проблема процесса, а не данных, и стоит она одного разговора.
Почему точка захвата дешевле ретроспективной уборки?
Ретроспективное восстановление данных иногда не просто дорого, а невозможно — и это самый сильный аргумент в пользу ремонта точки захвата.
Той же миграции Auspex понадобилась незаметная на первый взгляд предосторожность. В Bitrix24 поле MOVED_TIME хранит дату последней смены стадии, и массовое перемещение лидов перезаписало бы его датой миграции — то есть история «когда лид реально застрял» исчезла бы навсегда, у всех 18 799 записей одновременно. Починить это после операции было бы нечем: значение не повреждено, оно перестало существовать. Поэтому исходную дату зафиксировали заранее, отдельным полем, ещё до перемещения.
Уборка работает только с тем, что сохранилось. Точка захвата определяет, сохранится ли вообще что-нибудь. Изменения в ней обычно мелкие и скучные:
- обязательная причина закрытия с закрытым списком значений вместо свободного текста;
- дедупликация по телефону и почте в момент создания записи, а не в момент отчёта;
- нормализация формата номеров и названий компаний сразу на входе;
- отдельное поле для юридической формы, чтобы «ООО Ромашка» и «Ромашка» не считались двумя клиентами;
- автозаполнение того, что система уже знает из истории коммуникации.
Ни один из этих пунктов не выглядит как AI-проект. Они определяют, будет ли через полгода на чём его строить.
Как выглядит первый месяц, пока данные ещё грязные?
Сценарий запускается на своём срезе и работает, пока остальная база остаётся в том же состоянии, что и была. Параллельно появляется то, чего до запуска не существовало: обратная связь о качестве данных в конкретном месте. Исправленное поле причины закрытия за несколько недель показывает, что половина значений в справочнике никогда не используется, а того, что нужно менеджерам, в списке нет.
Мерить стоит узко, в пределах того же среза:
- доля записей в срезе сценария с полностью заполненными полями;
- количество дублей в том же срезе, а не во всей базе;
- время на подготовку отчёта, который раньше собирали вручную;
- доля значений «другое» в справочниках, которые сценарий читает.
Обещать при этом конкретный множитель эффекта не с чего: он зависит от состояния базы и потока операций, которые до аудита неизвестны. Числа, которые появляются в коммерческих предложениях и расчётах окупаемости, — прогноз по исходным данным конкретной компании, а не измеренный результат.
Когда возражение справедливо?
Есть случаи, когда «сначала данные» — правильный ответ, и честно назвать их важнее, чем продать пилот:
- Сценарий читает всю базу, а не срез: массовая рассылка, реактивация спящих контактов, отчётность за всю историю. Здесь качество каждой записи влияет на результат, а дубли означают, что клиент получит два письма.
- Решение принимается автоматически и необратимо: списание, оплата, изменение условий договора. Цена ошибочной записи измеряется не неудобством.
- Ошибка видна клиенту. Дубль в базе — это второй звонок тому же человеку в тот же день.
В этих случаях работает последовательность, описанная в материале «Бизнес, который обновляет себя сам»: нормализованные справочники, затем контроль на входе, затем изменения по предложению AI с подтверждением человека. Порядок там важнее скорости, и пропускать шаги не стоит.
Разница между тем материалом и этим — в вопросе, на который они отвечают. Там речь о том, в каком порядке созревает слой данных. Здесь — о том, какого объёма работа нужна, чтобы сделать первый шаг. Оба сводятся к одному: работа с данными неизбежна, но её границы задаёт сценарий, а не размер базы.
Какой следующий шаг?
Auspex — компания по внедрению CRM и автоматизации бизнес-процессов для SMB. Разговор об автоматизации начинается с двух вопросов, а не с выбора инструмента или объёма вашей базы: какой сценарий вы хотите запустить первым и какие пять полей он читает. Ответ на них обычно показывает, что данных для старта больше, чем казалось, а работы — меньше. Надстройка в виде AI-агентов для поддержки или квалификации лидов имеет смысл тогда, когда этот слой закрыт; этим направлением занимается Grow2.ai — наше AI-подразделение.