
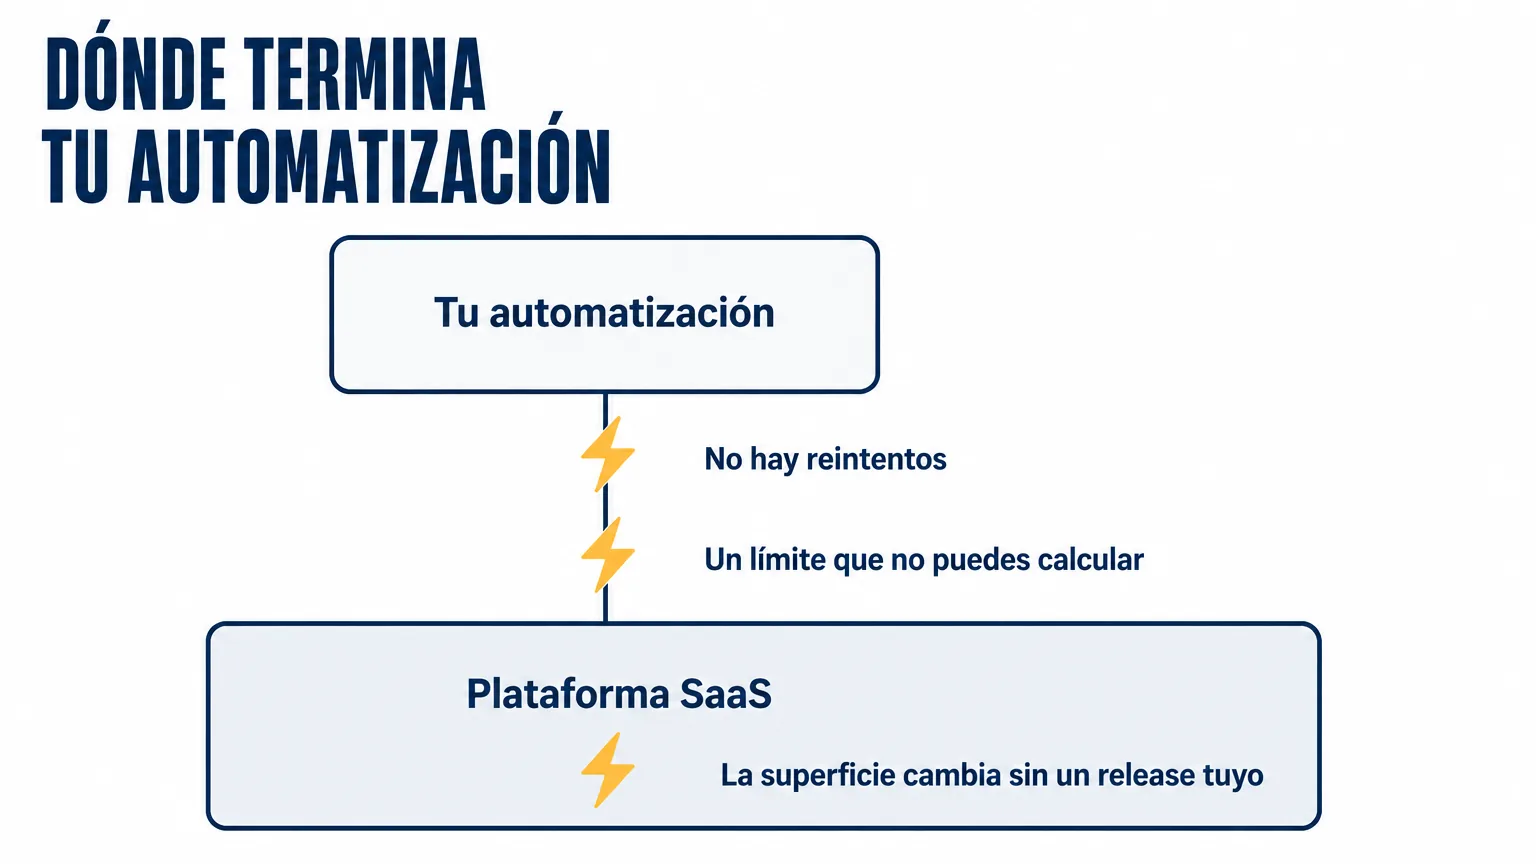
En el diagrama, una integración se ve como dos rectángulos y una flecha entre ellos: tu sistema y el CRM. El rectángulo derecho está dibujado igual que el izquierdo, con línea continua, como si dentro rigieran las mismas reglas que de tu lado. Ahí hay código ajeno, un calendario de releases ajeno, una red ajena y un abogado ajeno. No ves los logs, no sabes la fecha de la próxima actualización, no puedes revertir una versión, y lo único que te llega de esa mitad es una respuesta HTTP.
Cuando una automatización se rompe, la primera hipótesis casi siempre es «un bug en la integración», y la empresa acude al contratista. Parte de esos fallos se produjo al otro lado de la frontera, donde ni tú ni el contratista tenéis permisos ni visibilidad. Averiguar qué parte exactamente sale más barato antes del incidente.
¿Por qué una respuesta exitosa no significa que la acción se ha ejecutado?
La clase de fallos más cara es aquella en la que nada se cae. La plataforma acepta la solicitud, devuelve un código de éxito y no hace lo que le pediste.
A continuación, lo que Auspex midió con sus propias pruebas en un portal de Uspacy en agosto de 2026. No es una queja contra un proveedor en particular: Uspacy tiene documentación pública completa de su API REST con esquemas OpenAPI, algo de lo que no toda plataforma puede presumir. Simplemente es el que medimos, y la frontera se ve así:
- los valores de lista enviados dentro de un campo al crear ese campo, el portal los descarta: el campo se crea vacío, no hay error, el estado es 201
- escribir los permisos de un rol reemplaza todo el conjunto de permisos sobre embudos en lugar de complementarlo, así que guardar un permiso borra los demás, y también con éxito
- al crear una tarea, tres de los cinco estados se aceptan con código 201 y se convierten en silencio en «planificada», y el valor sustituido ya viene en el cuerpo de la respuesta
- un permiso escrito sobre un embudo del sistema devuelve 200 y no se guarda: la plantilla de permisos aparece en la entidad solo en el momento en que se crea su primer embudo propio
- en el cuerpo del error, el campo status vale true: la marca de éxito está presente incluso cuando la operación no se realizó
Cada punto por separado es un detalle que se ve en cinco minutos mirando el portal. Juntos dicen otra cosa: el código de respuesta confirma que la solicitud fue aceptada, no que el estado haya cambiado como querías. Una integración construida sobre la verificación del estado HTTP da por ejecutado todo lo que no se cayó.
La documentación describe la intención del proveedor; una prueba en vivo, el comportamiento real. La diferencia entre ambos corre por tu cuenta.
¿Qué significa «no hay reintentos»?
Un webhook es una llamada automática que la plataforma envía a tu sistema cuando algo ocurre en ella. Parece una garantía: ha ocurrido un evento, ha llegado una solicitud. Los proveedores que escriben sobre esto con franqueza dicen lo contrario, y Bitrix24 es el más directo. En la sección sobre eventos, su documentación enumera dos limitaciones sin suavizar nada.
Load cannot be regulated. When mass data changes occur, you will receive many consecutive calls. If a thousand deals are changed simultaneously in Bitrix24, the handler will receive a thousand calls. No retries. If your server does not respond or returns an error, the Bitrix24 queue server will log the failure but will not resend the event.
— Bitrix24 REST API documentation, sección Events
Traducción: la carga no se regula. Si en Bitrix24 cambian mil oportunidades al mismo tiempo, el manejador recibirá mil llamadas. No hay reintentos: si tu servidor no ha respondido o ha devuelto un error, el servidor de colas registrará el fallo, pero no volverá a enviar el evento.
Bitrix24 no es peor que los demás en esto: simplemente lo ha dicho en voz alta. Shopify lo formula con más dureza todavía:
Your app shouldn't rely on receiving data from Shopify webhooks. Webhook delivery isn't always guaranteed, and your app can miss or mishandle events for other reasons, such as handler failures or downtime. For redundancy, use reconciliation jobs to periodically fetch data from Shopify so that your app stays consistent with Shopify's data.
— Shopify Developer Documentation, Build webhooks
Traducción: no dependas de que los datos lleguen por webhook. La entrega no está garantizada, y la aplicación puede perder un evento por razones propias: un fallo del manejador o un período de inactividad. Para mayor fiabilidad, ejecuta una conciliación que periódicamente recoja por sí misma los datos de Shopify.
Aun así, Shopify reintenta la entrega ocho veces a lo largo de cuatro horas y, tras ocho intentos fallidos consecutivos, elimina la suscripción, con un aviso por correo a la dirección técnica de la aplicación. GitHub no reintenta en absoluto: si tu servidor no ha respondido en diez segundos, la entrega se marca como fallida, y solo se puede reenviar a mano o con un script propio, y solo las de los últimos tres días.
Las políticas son distintas; la conclusión para ti es la misma: un proceso que solo existe en el momento del webhook no es un proceso, es una esperanza. Al lado debe haber una conciliación periódica: cada N minutos, pedir la lista de entidades modificadas en la ventana y compararla con lo que has recibido. La discrepancia de la semana pasada muestra tu nivel actual de pérdidas, y es mejor conocerlo con un número.
El peor caso es cuando no hay con qué conciliar. En Bitrix24, el método que obtiene las publicaciones del feed de noticias no devuelve los destinatarios de la publicación, así que es imposible comprobar por API a qué grupo de trabajo ha ido a parar una publicación: solo mirando el portal.
¿Qué límite no puedes calcular?
Bitrix24 documenta sus límites en detalle, y eso es bueno: la limitación de intensidad funciona según el principio de leaky bucket, el contador baja 2 solicitudes por segundo, el umbral de bloqueo es 50, en el plan Enterprise son 5 y 250 respectivamente, y superarlo devuelve un 503 con el código QUERY_LIMIT_EXCEEDED.
El límite se cuenta por la dirección IP de origen de la solicitud, así que varias aplicaciones en un mismo servidor comparten un presupuesto común. Tu segunda integración se come en silencio la cuota de la primera, y en los logs de la primera eso se verá como fallos aleatorios de la plataforma.
Al lado vive un segundo límite: el del tiempo acumulado de ejecución de un método, con el código OPERATION_TIME_LIMIT y un 429 como respuesta. Su umbral para la nube no figura en la documentación: ahí solo se dice que se define por configuración, y la cifra de 420 segundos corresponde a la versión on-premise, donde la limitación viene desactivada por defecto. Y ahí mismo se señala que una misma solicitud consume en distintos portales un volumen distinto de ese límite, porque procesa una cantidad distinta de registros, por lo que el consumo de recursos de una solicitud no se puede determinar solo del lado de la aplicación.
Un límite cuyo consumo no se puede medir desde tu lado no se puede incorporar a la arquitectura: lo único posible es no excederlo a ciegas.
Uspacy está hecho al revés. Ejecutamos en su portal 152 llamadas de creación y eliminación de registros con distinta cantidad de hilos: ninguna devolvió 429, y el rendimiento creció casi linealmente: un hilo daba cerca de un registro por segundo, cuatro daban 4,9, ocho daban 8,1, y a partir de ahí la curva se doblaba. Leer esto como «no hay límites» es el error más caro posible. Se midió el comportamiento de un portal en un día, y en la documentación pública de Uspacy no hay ninguna mención de límites ni del código 429, ni de reintentos de entrega, ni de idempotencia (la garantía de que un evento entregado por segunda vez no creará un segundo registro). Un límite que no está en la documentación tampoco tiene la obligación de seguir ausente: se puede introducir sin anuncio justamente porque nunca se prometió nada sobre él.
Por eso una cola con backoff exponencial hace falta incluso donde nunca ha llegado un 429. Cuesta un día de trabajo una sola vez y te ahorra reescribir el pipeline la semana en que aparezca el límite.
¿Por qué la superficie cambia sin un release tuyo?
El 14 de agosto de 2026, a un webhook en uso de Bitrix24 en nuestro portal le aparecieron tres permisos de acceso nuevos que antes no existían. En torno a su ausencia se había construido una solución alternativa: la lista de grupos de trabajo se obtenía a través del historial de mensajes. Esa solución dejó de hacer falta de la noche a la mañana, y ese día no hubo ningún release nuestro.
La ampliación de permisos es un cambio agradable. Su mecanismo es el mismo que el de uno desagradable: la superficie en la que se apoya tu código ha cambiado desde fuera, y nos enteramos porque estábamos revisando, no porque nos avisaran. Según nuestro conteo sobre el changelog público de Bitrix24 (corte a principios de septiembre de 2026), en los primeros ocho meses del año salieron 355 cambios documentados de la API en 91 lanzamientos. Es el ritmo del proveedor, y tu ciclo de releases no tiene nada que ver con él.
Hasta dónde puede llegar esto se ve en la dispersión de los preavisos que distintas plataformas han dado en los últimos años. En febrero de 2023, Twitter anunció el fin del acceso gratuito a la API siete días antes de la fecha de corte, y en marzo de ese mismo año dio treinta días para migrar desde todos los planes antiguos. Reddit, en junio de 2023, puso precio —0,24 dólares por cada mil llamadas— aproximadamente un mes antes de empezar a cobrar; el autor del cliente Apollo pidió públicamente tres meses y no los obtuvo. En el otro extremo, Shopify se compromete a mantener cada versión de la API al menos doce meses, con una superposición entre versiones contiguas de no menos de nueve, y Salesforce avisó de la retirada de versiones antiguas con unos cuatro años y medio de anticipación y extendió voluntariamente el plazo tras consultar con la comunidad.
La diferencia entre siete días y cuatro años no es una característica técnica, sino lo que el proveedor escribió sobre sí mismo. Se puede leer antes de firmar el contrato, no después.
El acuerdo de licencia de Bitrix24 le reserva a la plataforma el derecho de restringir el acceso al portal ante una carga excesiva, y la página de soporte explica el procedimiento: ante una carga no crítica, al primer administrador le envían un mensaje pidiéndole que contacte con soporte y, si no responde, bloquean la fuente de la carga; ante una carga alta, la bloquean de inmediato. No hay umbral numérico, no hay plazo de preaviso, no hay procedimiento de apelación. Los límites documentados muestran el mínimo; el techo se lo reserva el proveedor.
¿Quién más está en la cadena sin un contrato contigo?
El último proveedor de la cadena es aquel con el que no tienes contrato. Es la red. En España, los operadores de internet bloquean direcciones por IP durante las retransmisiones de fútbol, y junto con los piratas caen todos los vecinos de la misma dirección edge: según cálculos de OONI, medio millón de dominios en dos mil direcciones, y lo que recibe el golpe son justamente las llamadas entre máquinas: webhooks, callbacks de pago, ingest. Nuestro propio servicio en producción estuvo inaccesible desde España varias noches seguidas en agosto de 2026 precisamente por eso, mientras todas sus métricas seguían en verde. El análisis de esa frontera, con cifras y una verificación de una hora, está en una nota aparte; el enlace está abajo.
¿Qué hacer con esto sin reescribirlo todo?
La protección frente a la frontera son cuatro hábitos y un documento. Aquí no hace falta una reforma de arquitectura.
- lleva tu propio registro de eventos append-only de tu lado, independiente de la plataforma: sin él, la pregunta «¿cuánto hemos perdido?» simplemente no tiene respuesta
- pon una conciliación periódica junto a los webhooks: el webhook trae el evento en segundos, la conciliación recoge lo que no llegó
- relectura después de escribir allí donde la escritura tiene un precio: compara con la intención, no con el código de respuesta
- cola con backoff por defecto, incluso cuando el límite no está documentado en ninguna parte
El quinto punto es el documento, y es el más importante: la lista de lo que el proveedor no te prometió. Garantía de entrega de eventos, política de reintentos, límite de solicitudes y forma de medirlo, ventana de deprecación, procedimiento ante un bloqueo por carga: junto a cada línea va un enlace a la documentación o la palabra «no». Todo lo que tiene un «no» al lado lo cubres tú o decides conscientemente no cubrirlo. No hay tercera opción: solo hay una sin aclarar.
¿Dónde deja de funcionar este consejo?
La reacción exagerada más común es una capa de abstracción «para después cambiar de CRM fácilmente». Encarece cada funcionalidad hoy por un evento cuya fecha y probabilidad se desconocen, y en la práctica describe justo la plataforma a partir de la cual se escribió.
La segunda es duplicar la plataforma con un servicio propio. Entonces te conviertes en tu propio proveedor: los mismos fallos silenciosos, solo que sin un equipo de soporte ajeno y sin un presupuesto ajeno para mantenerlo.
La proporción es simple. La protección debe costar menos que las pérdidas esperadas: para un proceso de veinte consultas al mes, un registro de eventos propio es un exceso; para un pipeline por el que pasan todas las llamadas entrantes, es lo mínimo.
Tres verificaciones por las que conviene empezar
- toma una integración y escribe dos listas: qué puedes arreglar tú en ella y qué no. Lee la segunda con atención: todo lo que está en ella ya no es tuyo
- abre la documentación de tu plataforma y busca las respuestas a cinco preguntas: si se reintentan las entregas fallidas de eventos, cuál es el límite de solicitudes, cómo medirlo desde tu lado, cuánto vive una versión de la API y qué pasa si se excede la carga; la falta de respuesta también es una respuesta
- compara la cantidad de eventos recibidos por webhook durante la semana pasada con la cantidad que hay en la plataforma para el mismo período
Si el tercer punto arroja una discrepancia, lo demás se puede omitir: la pérdida silenciosa ya existe y se sigue acumulando mientras nadie la cuente.
Una cosa más, que se nota ya en el segundo incidente: el registro de eventos no debe vivir donde vive la integración. Si tu log se cae junto con lo que registra, te enteras de la pérdida al mismo tiempo que de todo lo demás, es decir, por el cliente.
Calcula esa discrepancia de la semana pasada y tráela a una auditoría de CRM y automatizaciones. En una sola reunión, Auspex analiza qué partes de tu automatización están al otro lado de la frontera y cuáles conviene cubrir primero. La página del servicio está en los enlaces de abajo.
Fuentes
- Bitrix24 REST API — Events: overview
- Bitrix24 REST API — Incoming event queue
- Uspacy — API Reference: Introduction (autenticación)
- Bitrix24 REST API — límites de intensidad y de tiempo de ejecución de los métodos
- Shopify Developer Documentation — Build webhooks: reconciliation jobs (fuente original de la cita)
- Shopify — Verify webhook deliveries: 8 intentos en 4 horas, eliminación de la suscripción
- Shopify — API versioning: 12 meses de soporte, 9 meses de superposición
- GitHub Docs — Handling failed webhook deliveries
- Uspacy — documentación pública de la API REST: índice de todos los métodos