
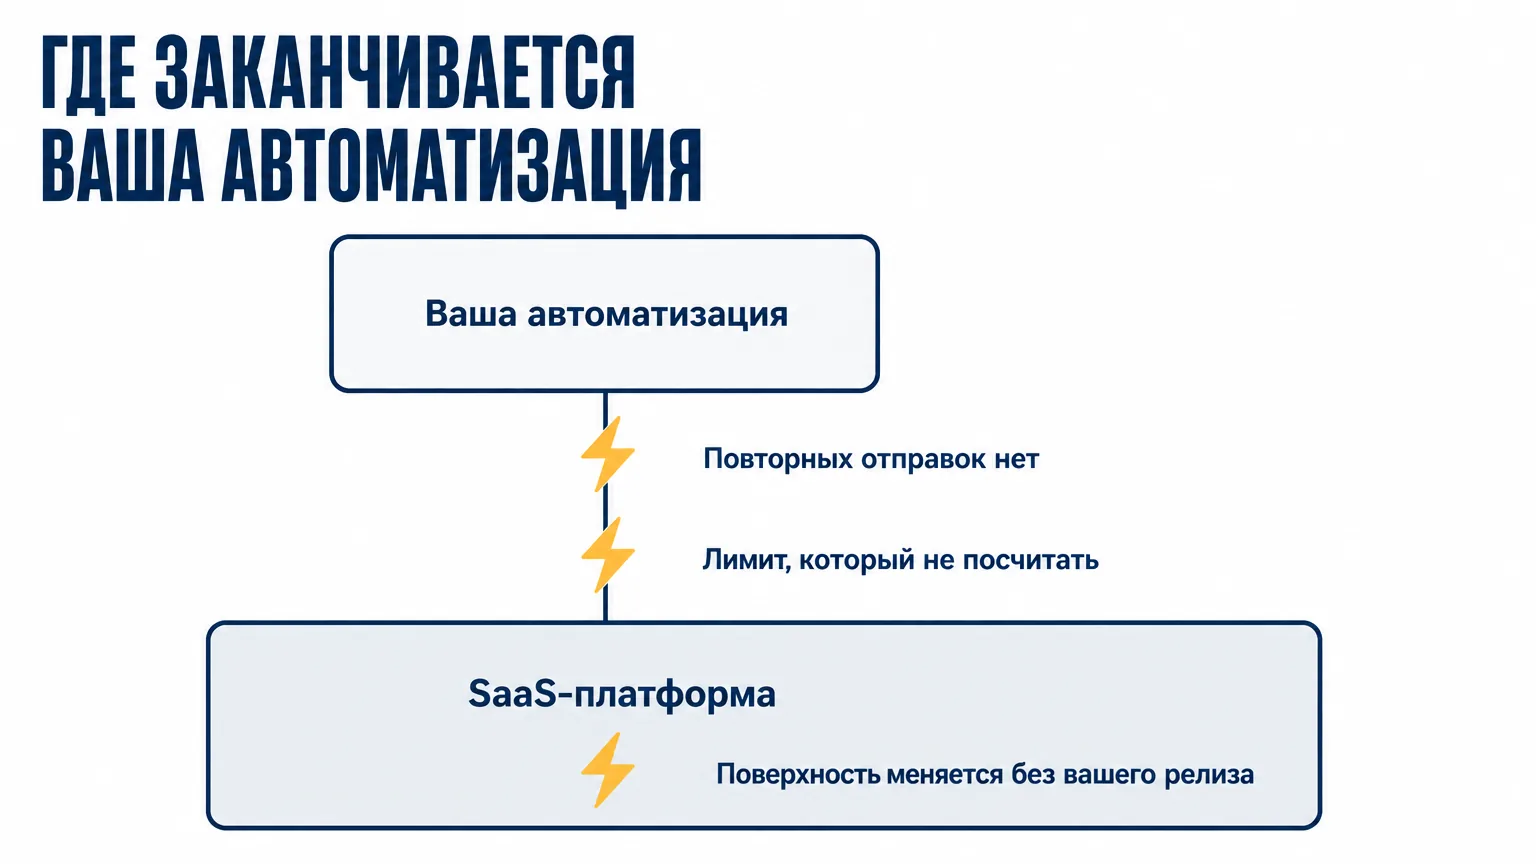
На схеме интеграция выглядит как два прямоугольника и стрелка между ними: ваша система и CRM. Правый прямоугольник нарисован так же, как левый, — сплошной линией, будто внутри него действуют те же правила, что и у вас. Там чужой код, чужой график релизов, чужая сеть и чужой юрист. Вы не видите логов, не знаете даты следующего обновления, не можете откатить версию, и единственное, что вам достаётся от той половины, — HTTP-ответ.
Когда автоматизация ломается, первой версией почти всегда становится «баг в интеграции», и компания идёт к подрядчику. Часть этих поломок случилась по ту сторону границы, где ни у вас, ни у подрядчика нет ни прав, ни видимости. Выяснить, какая именно часть, дешевле до инцидента.
Почему успешный ответ не означает выполненное действие?
Самый дорогой класс отказов — тот, в котором ничего не падает. Платформа принимает запрос, возвращает код успеха и не делает того, о чём вы просили.
Ниже — то, что Auspex замерил собственными прогонами на портале Uspacy в августе 2026 года. Это не претензия к конкретному вендору: у Uspacy есть полная публичная документация REST с OpenAPI-схемами, чем может похвастаться не каждая платформа. Просто замеряли мы именно его, и граница выглядит так:
- значения списка, переданные внутри поля при создании этого поля, портал отбрасывает — поле создаётся пустым, ошибки нет, статус 201
- запись прав роли заменяет весь набор прав на воронки, а не дополняет его, так что сохранение одного права стирает остальные — и тоже успешно
- при создании задачи три статуса из пяти принимаются с кодом 201 и молча превращаются в «запланированную», причём подменённое значение приходит уже в теле ответа
- право, записанное на системную воронку, возвращает 200 и не сохраняется: заготовка прав появляется у сущности только в момент создания её первой собственной воронки
- в теле ошибки поле status равно true — признак успеха стоит и тогда, когда операция не прошла
Каждый пункт по отдельности — мелочь, которую за пять минут видно глазами в портале. Вместе они говорят другое: код ответа подтверждает, что запрос принят, а не что состояние изменилось так, как вы хотели. Интеграция, построенная на проверке HTTP-статуса, считает выполненным всё, что не упало.
Документация описывает намерение вендора, живой прогон — фактическое поведение. За разницу между ними отвечаете вы сами.
Что означает «повторных отправок нет»?
Вебхук — это автоматический вызов, который платформа отправляет вашей системе, когда у неё что-то произошло. Выглядит как гарантия: произошло событие — прилетел запрос. Вендоры, которые пишут об этом прямо, говорят обратное, и Bitrix24 здесь самый прямолинейный. В разделе о событиях его документация перечисляет два ограничения без всяких смягчений.
Load cannot be regulated. When mass data changes occur, you will receive many consecutive calls. If a thousand deals are changed simultaneously in Bitrix24, the handler will receive a thousand calls. No retries. If your server does not respond or returns an error, the Bitrix24 queue server will log the failure but will not resend the event.
— Bitrix24 REST API documentation, раздел Events
Перевод: нагрузка не регулируется. Если в Bitrix24 одновременно меняется тысяча сделок, обработчик получит тысячу вызовов. Повторов нет: если ваш сервер не ответил или вернул ошибку, сервер очередей зафиксирует сбой в журнале, но событие ещё раз не отправит.
Bitrix24 в этом не хуже других — он просто сказал это вслух. Shopify формулирует ещё жёстче:
Your app shouldn't rely on receiving data from Shopify webhooks. Webhook delivery isn't always guaranteed, and your app can miss or mishandle events for other reasons, such as handler failures or downtime. For redundancy, use reconciliation jobs to periodically fetch data from Shopify so that your app stays consistent with Shopify's data.
— Shopify Developer Documentation, Build webhooks
Перевод: не полагайтесь на то, что данные придут вебхуком. Доставка не гарантирована, и приложение может пропустить событие по собственным причинам — из-за сбоя обработчика или простоя. Для надёжности запускайте сверку, которая периодически сама забирает данные из Shopify.
При этом Shopify повторяет доставку восемь раз в течение четырёх часов — и после восьми неудачных попыток подряд удаляет подписку, предупредив письмом на технический адрес приложения. GitHub не повторяет вообще: если ваш сервер не ответил за десять секунд, доставка помечается как неудачная, а переслать её можно только руками или собственным скриптом и только за последние трое суток.
Политики разные, вывод для вас один: процесс, который существует только в момент вебхука, — это не процесс, а надежда. Рядом должна стоять периодическая сверка: раз в N минут запросить список сущностей, изменённых за окно, и сравнить с тем, что вы приняли. Расхождение за прошлую неделю показывает ваш текущий уровень потерь, и лучше знать его числом.
Худший случай — когда сверять нечем. В Bitrix24 метод, который отдаёт посты живой ленты, не возвращает адресатов публикации, поэтому проверить через API, в какую рабочую группу ушёл пост, невозможно: только глазами в портале.
Какой лимит вы не можете посчитать?
Bitrix24 документирует свои лимиты подробно, и это хорошо: ограничение интенсивности работает по принципу дырявого ведра, счётчик убывает на 2 запроса в секунду, порог блокировки — 50, на тарифе Enterprise соответственно 5 и 250, а превышение даёт 503 с кодом QUERY_LIMIT_EXCEEDED.
Лимит считается по IP-адресу источника запроса, поэтому несколько приложений на одном сервере делят общий бюджет. Ваша вторая интеграция молча съедает квоту первой, и в логах первой это будет выглядеть как случайные сбои платформы.
Рядом живёт второй лимит — на накопленное время выполнения метода, с кодом OPERATION_TIME_LIMIT и 429 в ответ. Его пороговое значение для облака в документации не приведено: там сказано лишь, что оно задаётся конфигурацией, а число 420 секунд относится к коробочной версии, где ограничение по умолчанию выключено. И там же отмечено, что один и тот же запрос в разных порталах расходует разный объём этого лимита, потому что обрабатывает разное количество записей, а значит, ресурсоёмкость запроса невозможно определить только на стороне приложения.
Лимит, расход которого не измеряется с вашей стороны, нельзя заложить в архитектуру — его можно только не превышать наугад.
Uspacy устроен наоборот. Мы прогнали на его портале 152 вызова с созданием и удалением записей с разным числом потоков: ни один не вернул 429, а пропускная способность росла почти линейно — один поток давал около одной записи в секунду, четыре — 4,9, восемь — 8,1, дальше кривая загибалась. Прочитать это как «лимитов нет» — самая дорогая ошибка из возможных. Замерено поведение одного портала в один день, а в публичной документации Uspacy нет ни одного упоминания ни о лимитах и коде 429, ни о повторах доставки, ни об идемпотентности — гарантии, что повторно доставленное событие не создаст вторую запись. Если лимита нет в документации, нет и обязательства, что он не появится: его можно ввести без анонса именно потому, что о нём никогда ничего не обещали.
Поэтому очередь с экспоненциальным backoff нужна даже там, где 429 не приходил ни разу. Она обходится в один день работы, причём один раз, и избавляет от переписывания конвейера в ту неделю, когда лимит появится.
Почему поверхность меняется без вашего релиза?
14 августа 2026 года у рабочего вебхука Bitrix24 на нашем портале появились три новых права доступа, которых раньше не было. Под их отсутствие был построен обходной путь: список рабочих групп доставали через историю сообщений. Обход стал ненужным за одну ночь, и ни одного нашего релиза в тот день не было.
Расширение прав — приятное изменение. Механизм у него тот же, что и у неприятного: поверхность, на которую опирается ваш код, изменилась извне, и мы узнали об этом, потому что проверяли, а не потому что нас уведомили. По нашему подсчёту на основе публичного changelog Bitrix24 (срез на начало сентября 2026), за первые восемь месяцев года вышло 355 задокументированных изменений API в 91 выпуске. Это темп вендора, к которому ваш релизный цикл не имеет никакого отношения.
Насколько далеко это может зайти, видно по разбросу сроков предупреждения, которые разные платформы давали за последние годы. В феврале 2023-го Twitter объявил о прекращении бесплатного доступа к API за семь дней до даты отключения, а в марте того же года дал тридцать дней на миграцию со всех старых тарифов. Reddit в июне 2023-го назвал цену — 0,24 доллара за тысячу вызовов — примерно за месяц до начала списаний; автор клиента Apollo публично просил три месяца и не получил их. На другом полюсе Shopify обязуется поддерживать каждую версию API не менее двенадцати месяцев с перекрытием соседних версий не менее девяти, а Salesforce предупреждал о выводе старых версий примерно за четыре с половиной года и добровольно продлил срок после консультаций с сообществом.
Разница между семью днями и четырьмя годами — это не техническая характеристика, а то, что вендор сам о себе написал. Прочитать это можно до подписания договора, а не после.
Лицензионное соглашение Bitrix24 оставляет за платформой право ограничить доступ к порталу при чрезмерной нагрузке, а страница поддержки объясняет процедуру: при некритичной нагрузке первому администратору отправят сообщение с просьбой обратиться в поддержку, и если он не ответит, источник нагрузки заблокируют; при высокой — заблокируют сразу. Числового порога нет, срока предупреждения нет, порядка обжалования нет. Задокументированные лимиты показывают минимум; потолок вендор оставляет за собой.
Кто ещё стоит в цепочке без договора с вами?
Последний вендор в цепочке — тот, с которым у вас нет договора. Это сеть. В Испании провайдеры блокируют адреса по IP на время футбольных трансляций, и вместе с пиратами ложатся все соседи по edge-адресу: по подсчётам OONI, полмиллиона доменов с двух тысяч адресов, а под удар попадают именно машинные вызовы — вебхуки, платёжные callback, ingest. Наш собственный продакшн-сервис в августе 2026-го несколько вечеров подряд был недоступен из Испании именно из-за этого, пока все его метрики оставались зелёными. Разбор этой границы с цифрами и проверкой на час — в отдельной заметке, ссылка ниже.
Что с этим делать, не переписывая всё?
Защита от границы — это четыре привычки и один документ. Архитектурная реформа здесь не нужна.
- ведите собственный append-only журнал событий на своей стороне, независимый от платформы — без него у вопроса «сколько мы потеряли» просто нет ответа
- поставьте периодическую сверку рядом с вебхуками: вебхук привозит событие за секунды, сверка добирает то, что не доехало
- перечитывание после записи там, где у записи есть цена: сравнивайте с намерением, а не с кодом ответа
- очередь с backoff по умолчанию, даже когда лимит нигде не задокументирован
Пятый пункт — это документ, и он самый важный: список того, чего вендор вам не обещал. Гарантия доставки событий, политика повторов, лимит запросов и способ его измерить, окно депрекации, порядок действий при блокировке за нагрузку — в каждой строке напротив стоит либо ссылка на документацию, либо слово «нет». Всё, напротив чего стоит «нет», вы страхуете сами или сознательно не страхуете. Третьего варианта нет — есть только невыясненный.
Где этот совет перестаёт работать?
Самая распространённая чрезмерная реакция — слой абстракции, «чтобы потом легко сменить CRM». Он удорожает каждую фичу сегодня ради события, дата и вероятность которого неизвестны, и на практике описывает именно ту платформу, с которой его писали.
Вторая — дублировать платформу собственным сервисом. Тогда вы становитесь вендором сами себе: те же тихие отказы, только без чужой команды поддержки и без чужого бюджета на её содержание.
Пропорция простая. Защита должна стоить меньше ожидаемого ущерба: для процесса на двадцать заявок в месяц собственный журнал событий — излишество, для конвейера, через который идут все входящие звонки, — минимум.
Три проверки, с которых стоит начать
- возьмите одну интеграцию и выпишите два списка: что в ней вы можете починить сами и что — нет. Второй список читайте внимательно: всё, что в нём, уже не ваше
- откройте документацию вашей платформы и найдите ответы на пять вопросов: повторяются ли неудачные доставки событий, какой лимит запросов, как его измерить со своей стороны, сколько живёт версия API и что произойдёт при превышении нагрузки — отсутствие ответа тоже ответ
- сравните количество событий, полученных вебхуками за прошлую неделю, с количеством в платформе за тот же период
Если третий пункт даст расхождение, остальное можно не делать: тихая потеря уже есть и накапливается всё время, пока её никто не считает.
Ещё одно, что замечают уже на втором инциденте: журнал событий должен жить не там, где живёт интеграция. Если ваш лог падает вместе с тем, что он логирует, вы узнаете о потере одновременно со всем остальным — то есть от клиента.
Посчитайте это расхождение за прошлую неделю и приходите с ним на аудит CRM и автоматизаций. За одну встречу Auspex разбирает, какие части вашей автоматизации лежат по ту сторону границы и что из них стоит подстраховать первым. Страница услуги — в ссылках ниже.
Источники
- Bitrix24 REST API — Events: overview
- Bitrix24 REST API — Incoming event queue
- Uspacy — API Reference: Introduction (аутентификация)
- Bitrix24 REST API — лимиты интенсивности и времени выполнения методов
- Shopify Developer Documentation — Build webhooks: reconciliation jobs (первоисточник цитаты)
- Shopify — Verify webhook deliveries: 8 попыток за 4 часа, удаление подписки
- Shopify — API versioning: 12 месяцев поддержки, 9 месяцев перекрытия
- GitHub Docs — Handling failed webhook deliveries
- Uspacy — публичная документация REST API: перечень всех методов