
Почему ручная оценка звонков не масштабируется?
Руководитель отдела продаж, который сам переслушивает разговоры, упирается в арифметику. Допустим: тридцать минут на разбор одного звонка с заметками, команда из десяти менеджеров и 200–300 звонков в день. Даже если тратить на это по полдня каждый день, покрытие останется символическим.
В крупных контакт-центрах ручной контроль качества традиционно охватывает лишь небольшую выборку контактов — единицы процентов. Для небольших B2B-команд мы закладываем более оптимистичные 5–10%, потому что звонков там меньше. Даже по верхней границе это значит: 9 из 10 разговоров не видел никто, кроме менеджера и клиента.
Хуже самого процента то, как формируется выборка. Её почти никогда не делают случайной. Переслушивают то, на что пожаловался клиент, или то, где сделка развалилась. Получается систематический перекос: руководитель изучает катастрофы и не видит серой зоны — разговоров, которые закончились вежливым «мы подумаем» и тихо не дошли до следующего шага. Именно там прячется большая часть потерянной выручки, и именно туда ручной QA не дотягивается.
Разговор с менеджером из-за этого строится на двух-трёх запомнившихся эпизодах, а не на картине всей его работы. Это не коучинг, это разбор частных случаев.
Почему «подсказка в реальном времени» — не та цель?
Когда бизнес просит «AI-подсказки менеджеру», в голове обычно картинка из фильма: менеджер говорит с клиентом, а сбоку всплывает текст «спроси про бюджет». Идея привлекательная, и именно поэтому стоит сказать прямо: результата это не даёт, и мы сознательно этого не делаем.
Человек не может одновременно вести живой разговор и читать инструкции сбоку: подсказка не помогает, она рассеивает внимание, и клиент слышит паузу. Плюс простая физика: чтобы сгенерировать осмысленную рекомендацию, нужно распознать речь, понять контекст диалога и сопоставить его с методологией, а разговор не ждёт.
Подсказка в моменте ещё и не формирует навык. Менеджер, который выполняет команды с экрана, в следующий раз, когда экрана рядом не окажется, останется тем же менеджером: он попадает в зависимость от суфлёра, а сильнее не становится.
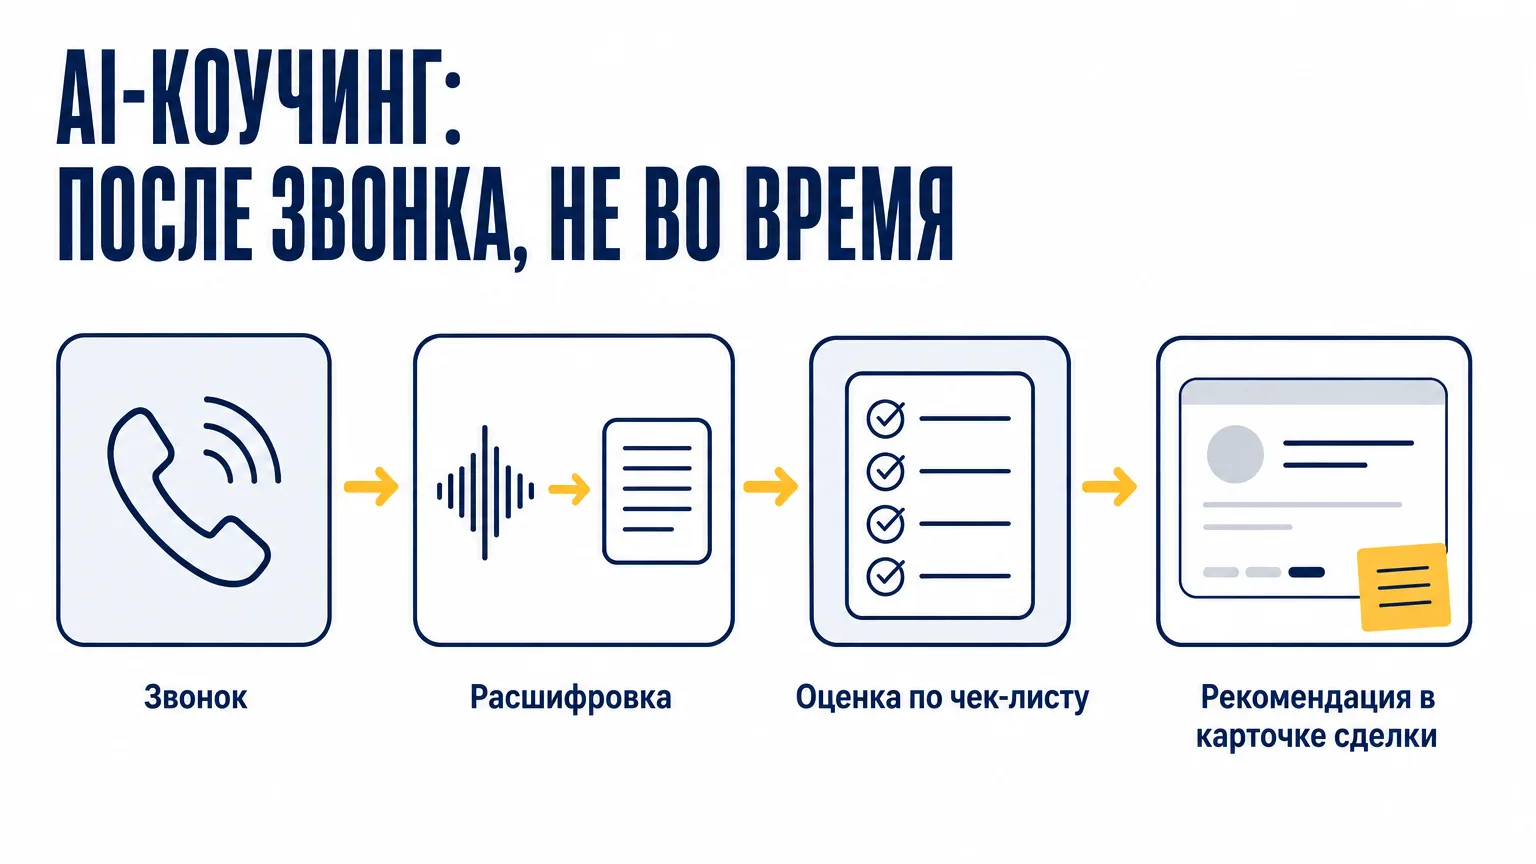
Рабочий цикл выглядит иначе. Разговор закончился, система его разобрала, менеджер получил оценку и одну конкретную рекомендацию — и держит её в голове, когда набирает следующий номер. Навык растёт между звонками, а не внутри них.
Что именно оценивает AI после разговора?
Технически цепочка простая: запись попадает в систему, система распознавания речи делает транскрипцию, языковая модель сопоставляет диалог с вашим чек-листом и возвращает структурированную оценку.
Ключевое слово здесь — «вашим». Универсальная оценка «звонок хорош на 7 из 10» ничего не стоит, потому что не подсказывает, что делать. Рабочий чек-лист состоит из проверок, на которые текст разговора даёт однозначный ответ:
- Выяснил ли менеджер, кто принимает решение, и участвует ли этот человек в разговоре.
- Прозвучал ли вопрос о бюджете или о порядке цифр.
- Следующий шаг — с конкретной датой, а не «созвонимся как-нибудь».
- Как отработаны возражения: менеджер ответил по существу или согласился и отступил.
- Сколько говорил менеджер и сколько клиент.
- Обещания, которые компания не может выполнить.
Последний пункт часто оказывается самым ценным и самым неприятным: именно он находит то, за что потом приходится отвечать юридически.
Из этих проверок складывается оценка за разговор и, что важнее, динамика по менеджеру за месяц. Видно не «Тарас молодец», а «Тарас стабильно не договаривается о следующем шаге в разговорах длиннее 15 минут».
Как результат доходит до менеджера?
Анализ, который лежит в отдельном кабинете, менеджер не откроет. Это главная причина, по которой QA-проекты умирают: данные есть, а поведение не меняется. Поэтому результат нужно доставлять туда, где человек уже работает, — в карточку сделки.
На практике это три вещи: поля с метриками в самой карточке, отчёт в ленте сделки с разделом рекомендаций — что менеджеру исправить, и уведомление руководителю, когда оценка ниже порога. Это делает Aelo — продукт нашего AI-подразделения Grow2.ai (aelo.cloud).
Целевой показатель — результат в карточке примерно через две минуты после завершения звонка. Две минуты — это планка, которую мы закладываем в продукт, а не усреднённый результат замеров на клиентских внедрениях: цифры, которые не можем подтвердить первичными данными, мы не публикуем.
Aelo работает с любой CRM: анализ разговоров от неё не зависит. Нативная интеграция построена под Bitrix24 — там результат ложится прямо в карточку сделки. Коннектор к вашей CRM делается под заказ: оценка за один рабочий день, поставка — две-три недели.
Что это значит для украинского бизнеса?
Самая глубокая интеграция Aelo построена под Bitrix24 — систему, которую украинский бизнес использовать не может. С 1 июня 2023 года, после санкций СНБО, облачные порталы Bitrix24 недоступны украинским пользователям. Для клиентов в Украине это не кандидат, и мы его не рекомендуем — о выборе CRM для украинского рынка есть отдельный разбор.
Что работает для украинской команды уже сейчас: сам анализ разговоров от CRM не зависит. Записи можно передавать тремя способами — напрямую из телефонии (Binotel, Ringostat, Unitalk, Stream Telecom), ручной загрузкой или через публичный API загрузки Aelo, если у вас есть свои разработчики. Транскрипция, оценка по чек-листу и динамика по менеджерам работают во всех трёх случаях.
Пока коннектора к вашей CRM нет, разрыв между «данные есть» и «поведение изменилось» приходится закрывать вручную: оценки и рекомендации выгружают из кабинета аналитики и разбирают на регулярной встрече один на один. Это работает, но держится на дисциплине руководителя — ровно той, которая с коннектором уже не понадобится. Поэтому планируйте так: оценка и рекомендации для коучинга — сегодня, автоматическая доставка в карточку вашей CRM — после того, как коннектор сделают под вас.
С чего начать?
Больше всего времени в таком проекте съедает не подключение, а договорённость о том, что считать хорошим разговором.
Начните с чек-листа на листе бумаги, до всякой автоматизации. Десять пунктов, у каждого однозначный ответ. Затем возьмите двадцать реальных звонков и оцените их дважды: руками руководителя и системой. Расхождения покажут, где формулировка пункта размыта, — и исправлять нужно чек-лист, а не модель. На практике чаще всего сыплется пункт про «выявление потребности»: каждый понимает его по-своему, и пока его не разложить на два-три конкретных вопроса, оценки не совпадут ни у кого.
Когда оценки совпадают, включайте доставку в CRM и оставьте сначала один триггер: уведомление при оценке ниже порога. Не десять уведомлений, одно. Команда должна успеть привыкнуть, что система не надзиратель, а зеркало.
И только после этого имеет смысл расширяться — на чаты, на другие воронки, на еженедельную динамику для планёрки.
Если хотите увидеть, что ваш чек-лист покажет на ваших реальных звонках, пришлите нам двадцать записей через форму на странице «Контакты». В ответ вернём отчёт с расхождениями: где оценка системы разошлась с оценкой вашего руководителя, какие пункты чек-листа дают наибольший прирост, а какие только создают шум.